Fisher–Yates 洗牌演算法:均勻排列、JavaScript 實作與常見陷阱
重新排列整份清單,和從中選出一個項目,是不同的操作。NanToo 日文版抽籤工具使用 Fisher–Yates 洗牌來決定抽出順序;輪盤工具則直接選擇一個索引。本文從歷史上的紙筆方法談起,說明現代交換演算法,以及結果均勻所需的條件。選對亂數來源,只是其中一環。
日文原文發布: 2026-04-29
什麼是均勻洗牌?
對於 n 個可區分的元素,共有 n! 種排列:3 個元素有 6 種、5 個有 120 種、10 個有 3,628,800 種。52 張不同的撲克牌則有約 8.07 × 10⁶⁷ 種排列。即使兩個元素的值相同,這裡仍以原始位置區分。
均勻洗牌的意思是,每一種排列出現的機率都是 1/n!。只讓每個元素出現在各位置的機率相同,仍不夠。例如只等機率輸出 ABC、BCA、CAB,雖然每個元素的位置分布均勻,卻永遠不會產生另外三種排列。
Fisher–Yates 要符合這個條件,必須在每一步,即使已知先前的選擇,仍均勻選出交換位置。因此,亂數來源以及將亂數轉成指定範圍整數的方法,也是正確性的一部分。
Fisher 與 Yates:從紙筆和亂數表開始
Ronald A. Fisher 與 Frank Yates 的 Statistical Tables for Biological, Agricultural and Medical Research 初版於 1938 年出版。參考資料所列的大學館藏是 1963 年第六版,不能把它當成 1938 年的版本。
紙筆做法是從剩餘元素中均勻選出一個,將它移除,再依序寫入另一份清單。這個想法可用於隨機安排實驗順序與分派對象。
1. 列出所有原始元素。
2. 從剩餘元素中均勻選出一個。
3. 將選中的元素加入輸出,並從原清單移除。
4. 重複以上步驟,直到沒有剩餘元素。
不論使用亂數表或軟體,把亂數轉成允許範圍內的整數時,都不能讓某些選項被選中的機會較高。接著來看如何在陣列上有效率地執行。
Durstenfeld 的交換法與 O(n) 時間
Richard Durstenfeld 在 1964 年的論文 Algorithm 235: Random Permutation 中,提出將隨機位置的元素與最後一個尚未確定的位置交換。若每次移除元素都要把後面的陣列元素往前搬,簡單實作可能需要 O(n²) 時間;交換則省去反覆搬移。
對 i 從 n−1 遞減到 1:
  從 [0, i] 均勻選出整數 j
  交換 arr[i] 與 arr[j]
j 的範圍是包含兩端的 0..i,交換後就確定位置 i。與自己交換也是必要的選項。若每次交換與取得亂數都視為常數時間,原地版本的時間複雜度為 O(n),額外空間為 O(1)。「原地」並不表示完全不使用額外記憶體。
Knuth 在 The Art of Computer Programming 第二卷以 Algorithm P 討論此方法,因此也稱為 Knuth shuffle。這個名稱不代表通過標準制定機構的認證。
為什麼每種排列的機率相同?
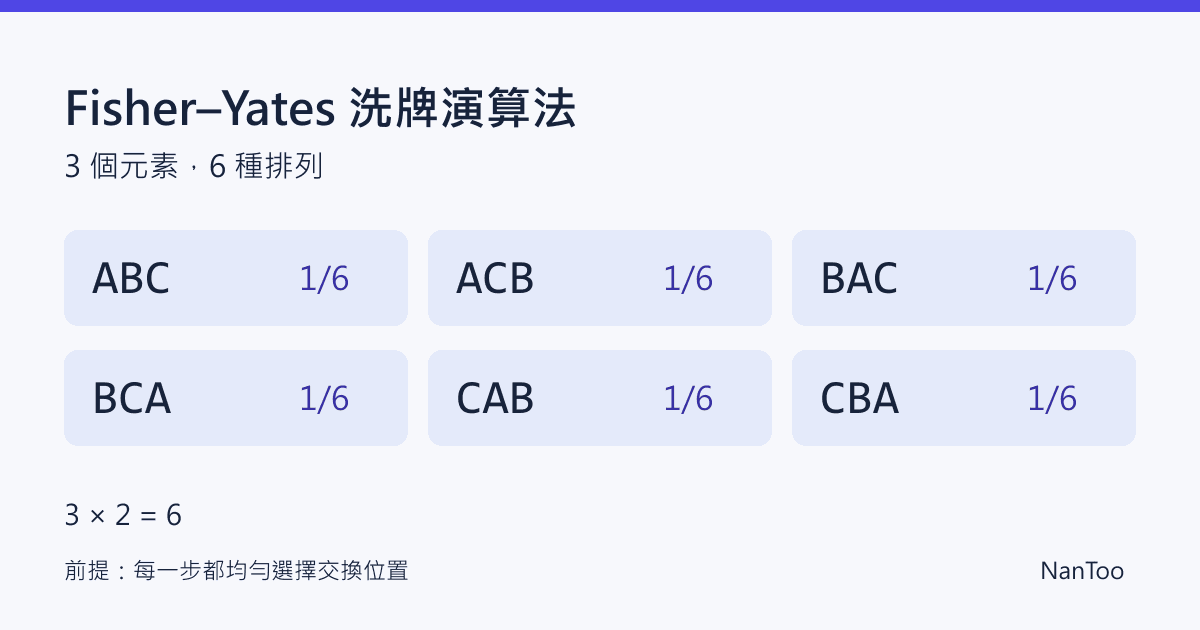
以 ABC 為例,第一次有 3 個交換位置可選,第二次有 2 個。每一步都均勻選擇時,下列 6 條路徑的機率各為 1/6。
表格若超出畫面寬度,可左右捲動。
| j(i=2) | j(i=1) | 結果 |
|---|---|---|
| 0 | 0 | BCA |
| 0 | 1 | CBA |
| 1 | 0 | CAB |
| 1 | 1 | ACB |
| 2 | 0 | BAC |
| 2 | 1 | ABC |
一般情況下,只要指定最終排列,就能從最後一個位置開始,依序唯一決定每次要選哪個元素。選擇路徑與排列之間是一對一對應,因此每個排列的機率是 1/n × 1/(n−1) × … × 1/2 = 1/n!。證明不只是數出 n! 條路徑,還需要這個一對一關係。
前提是每一步在已知先前選擇的情況下,仍以相同機率選到0..i 的每個整數。空陣列與只有一個元素的陣列都只有一種排列,直接原樣回傳即可。
陷阱一:用 sort 的隨機比較函式洗牌
不要把下面的寫法當成均勻洗牌:
arr.sort(() => Math.random() - 0.5);比較函式對同一組輸入應回傳一致的結果,並符合反身性、遞移性等要求。隨機比較違反這些條件。ECMAScript 將使用不一致比較函式時的排序結果列為實作相依,也沒有保證比較次數一定是 O(n log n),或必須使用某一種排序演算法。
偏差的具體樣貌會隨引擎、版本和輸入改變,不能說每種輸入都一定產生相同偏差。但只要無法保證均勻性,就不適合作為公平抽選的洗牌方法。另外,sort 會修改原始陣列。
陷阱二:每次都從整個陣列選交換對象
以下這種直覺寫法也有問題:
for (let i = 0; i < n; i++) {
  const j = Math.floor(Math.random() * n);
  [arr[i], arr[j]] = [arr[j], arr[i]];
}
當 n=3,即使假設每次整數選擇都均勻,也有 3³=27 條路徑要分配給 6 種排列,無法平均分配。完整列舉後,每種排列會出現 4 次或 5 次。不過,不能把這個結論泛化為 n=0 或 1 等簡單情況也一定有偏差。
遞減版本讓 i 從 n−1 到 1,並從 0..i 選 j。遞增版本則讓 i 從 0 到 n−2,並從 i..n−1 選 j。不能只改變迴圈方向,卻保留原本的交換範圍。
若遞減版本把 i 本身排除,只從 0..i−1 選擇,就成為 Sattolo 類型的單一循環生成方法。它與產生所有排列的目的不同,不能代替允許元素留在原位的均勻洗牌。
陷阱三:取餘數偏差與可執行的瀏覽器範例
將均勻的 32 位元無號整數 r 除以 n 並取餘數,若 2³² 不能被 n 整除,就會出現取餘數偏差(modulo bias)。令 2³² = qn + k,則餘數 0..k−1 各對應 q+1 個原始值,其餘各對應 q 個。
n=7 時,q=613,566,756、k=4,兩類結果的機率相差 1/2³²。n=2³¹ 時沒有這種偏差;n=2³¹+1 時,部分結果的機率卻是其他結果的兩倍。因此,偏差不會隨 n 增大而單調增加。
拒絕取樣(rejection sampling)會捨棄大於或等於 limit = floor(2³²/n) × n 的值,再對接受的值取餘數。接受範圍的大小是 n 的倍數,每個餘數就對應相同數量的原始值。n=7 時,要捨棄最後 4 個值。
以下是瀏覽器可執行的範例,適用於沒有空洞的一般陣列。它會進行淺層複製,不修改原始陣列,但不會複製元素所參照的物件。若 Web Crypto 無法使用或發生例外,就回報失敗,不會改用 Math.random。
function unbiasedRandomInt(n) {
  const range = 2 ** 32;
  if (!Number.isInteger(n) || n < 1 || n > range) {
    throw new RangeError("請輸入 1 到 2^32 之間的整數");
  }
  const source = globalThis.crypto;
  if (!source || typeof source.getRandomValues !== "function") {
    throw new Error("無法使用 Web Crypto");
  }
  const limit = Math.floor(range / n) * n;
  const value = new Uint32Array(1);
  for (let attempt = 0; attempt < 128; attempt++) {
    source.getRandomValues(value);
    if (value[0] < limit) return value[0] % n;
  }
  throw new Error("亂數取樣未能完成");
}

function shuffledCopy(items) {
  if (!Array.isArray(items)) throw new TypeError("請傳入陣列");
  const result = [...items];
  for (let i = result.length - 1; i > 0; i--) {
    const j = unbiasedRandomInt(i + 1);
    [result[i], result[j]] = [result[j], result[i]];
  }
  return result;
}

console.log(shuffledCopy(["A", "B", "C"]));
交換部分為 O(n),複製陣列的空間為 O(n)。每次整數選擇最多嘗試 128 次,仍未接受就失敗。在每個 32 位元值都獨立且均勻的模型下,單次接受機率大於 1/2,連續拒絕 128 次的機率小於 2⁻¹²⁸。這個次數上限用來避免異常時無限迴圈,並不限制 Web Crypto 內部操作的耗時。若中途失敗,不會回傳部分完成的陣列。
Math.random 產生大於或等於 0、小於 1、近似均勻分布的值,但具體方法與離散值的構成在 ECMAScript 中屬於實作相依。它不保證密碼學用途所需的不可預測性,也不能直接斷言浮點數轉換後的整數嚴格均勻。Web Crypto 可填入整數型別陣列;這個範例選用 Uint32Array 取得 32 位元值,不表示 API 只支援 32 位元。Node.js 的 crypto.randomInt(0, i + 1) 則提供避免取餘數偏差的整數選擇。
各語言的洗牌 API:先確認契約與亂數來源
API 的規格要求與某個版本內部採用的演算法,要分開看待。下列 API 可重新排列陣列等資料,但預設亂數來源不一定適合密碼學用途。
表格若超出畫面寬度,可左右捲動。
| 環境 | API | 注意事項 |
|---|---|---|
| Python | random.shuffle(x) | 修改原本的可變序列;預設 random 不適合密碼學用途 |
| Java | Collections.shuffle(list) | 修改原始清單,也可指定亂數產生器 |
| Ruby | array.shuffle / shuffle! | 分別為回傳新陣列與修改原始陣列的版本 |
| PHP | shuffle($array) | 修改原始陣列並重新指定索引鍵;不適合密碼學用途 |
| Go | math/rand/v2.Shuffle | 需傳入交換函式;math/rand/v2 不適合密碼學用途 |
| Rust | rand::seq::SliceRandom::shuffle | 來自 rand 套件(crate),不是標準函式庫;需傳入亂數產生器 |
| C++ | std::shuffle | 需傳入均勻亂數產生器;規格未指定單一實作演算法 |
| JavaScript | 自行實作的函式等 | ECMAScript 2026 沒有 Array.prototype.shuffle |
不能把提案中的功能當成現行標準 API。請依用途考慮洗牌均勻性、亂數不可預測性,以及是否需要能重現結果的種子(seed)。有限週期的偽亂數產生器也有極限:陣列夠長時,不可能產生所有排列。
NanToo 日文版工具如何使用亂數
以下說明的是 NanToo 日文版工具的實作。
表格若超出畫面寬度,可左右捲動。
| 工具 | 是否需要洗牌 | 做法 |
|---|---|---|
| 抽籤 | 需要,用來決定抽出順序 | Web Crypto+拒絕取樣+Fisher–Yates |
| 輪盤 | 不需要,直接選一個索引 | Web Crypto+拒絕取樣 |
| 擲骰子 | 不需要,每次擲骰獨立選擇點數 | Web Crypto+拒絕取樣 |
| 密碼產生器 | 不需要,直接選擇各位置的字元 | Web Crypto+拒絕取樣 |
亂數來源、整數範圍轉換與排列演算法必須分別驗證。抽籤工具將 Web Crypto 的 32 位元值透過拒絕取樣轉成交換位置,再進行 Fisher–Yates 洗牌;骰子、輪盤與密碼產生器則直接選擇點數、候選項目或字元。演算法名稱本身不代表公平性已通過第三方稽核,也不保證整個使用情境的安全。
也可參考密碼強度與熵的說明,進一步區分亂數選擇與實際安全需求。
實作前的檢查重點
- 所有排列等機率,與每個元素的位置分布均勻,是不同的條件。
- 遞減 Fisher–Yates 必須在已知先前選擇時,仍從 0..i 均勻選出交換位置。
- 隨機 sort 比較、每次交換整個範圍、排除 i 本身,都不能代替均勻產生所有排列的方法。
- 可用拒絕取樣將均勻整數轉成指定範圍,同時設計輸入驗證與異常時的終止方式。
- 均勻性與不可預測性不同。只選對演算法,不等於符合公開抽獎的稽核要求。
洗牌後抽牌,不等於獨立抽選
從洗好的牌堆中抽牌且不放回,並不是獨立試驗。例如從 52 張牌抽出 2 張,兩張都是 A 的機率為 4/52 × 3/51 = 1/221。抽出第一張後,剩餘牌數已經改變。
相對地,若每次都以固定機率 p 獨立成功,成功次數可用二項分布描述。p=0.03、獨立抽選 33 次,至少成功一次的機率為 1−0.97³³ ≈ 63.4%。若有保底或機率隨次數改變,就不能直接套用同一個公式。計算前,先釐清是放回抽樣、不放回抽樣,還是另有保底規則。
參考資料與來源
- Fisher and Yates — Statistical Tables, 6th edition (1963); University of Adelaide ↗
- Durstenfeld (1964), Algorithm 235: Random Permutation, CACM 7(7), 420 ↗
- Algorithm 235 — Collected Algorithms from ACM, Volume II(原論文重刊) ↗
- Donald Knuth — The Art of Computer Programming, Volume 2 ↗
- ECMAScript 2026 — Array.prototype.sort / SortIndexedProperties ↗
- ECMAScript 2026 — Math.random ↗
- W3C Web Cryptography Level 2 — getRandomValues ↗
- Node.js — crypto.randomInt ↗
- Python — random.shuffle ↗
- Java SE 25 — Collections.shuffle ↗
- Ruby 3.4 — Array.shuffle ↗
- PHP — shuffle ↗
- Go — math/rand/v2.Shuffle ↗
- Rust rand — SliceRandom.shuffle ↗
- C++ 工作草案 — shuffle ↗
編輯說明
本文使用 AI 協助編輯,並於發布前由編輯確認。內容仍可能包含事實、解讀或時效上的錯誤;進行重要判斷前,請查閱所列的一手資料或官方文件。