Web Speech API 原理與瀏覽器語音合成歷史:從 DECtalk 到神經網路 TTS
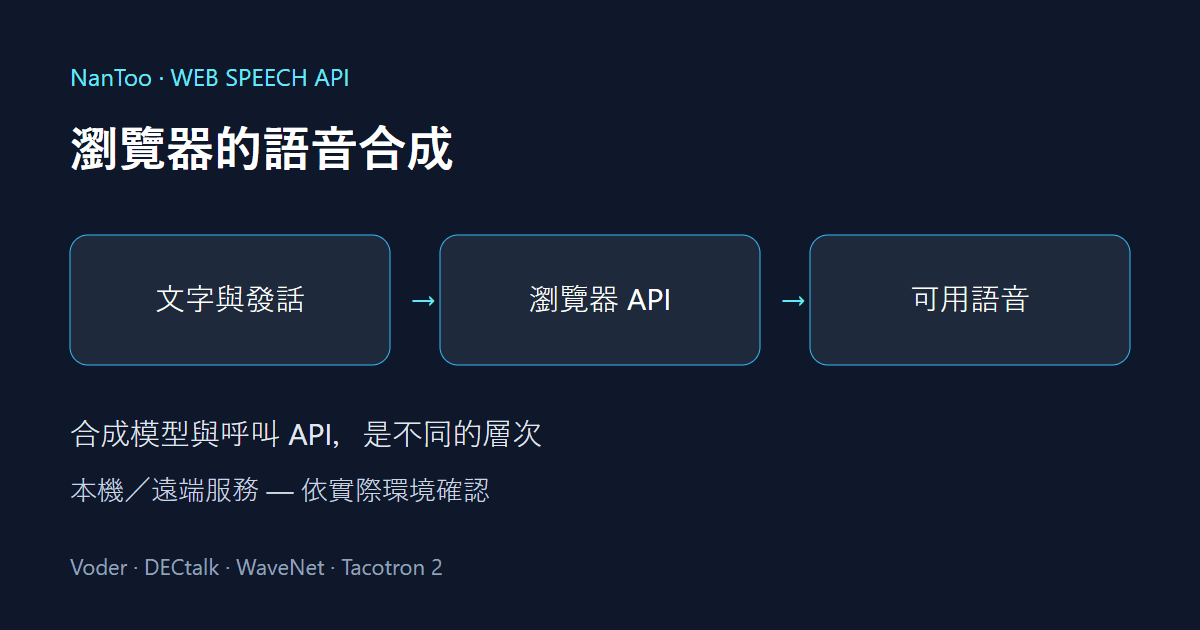
瀏覽器朗讀文字時,會把發話物件交給語音引擎處理。Web Speech API 本身並不是產生聲音的模型。本文從 Voder、DECtalk 到神經網路 TTS 的發展談起,再說明網頁開發時如何選擇語音、確認隱私條件與管理播放狀態。
日文原文發布: 2026-05-13
語音合成的歷史:Voder、DECtalk 與 CallText
1939 年紐約世界博覽會上,貝爾實驗室展示了 Homer Dudley 開發的 Voder。操作員利用鍵盤與踏板產生語音,與今天直接讀取文字的 TTS 系統不同。
1980 年代,DECtalk 在 Dennis Klatt 等人的研究基礎上問世,其中 Perfect Paul 以 Klatt 的聲音為基礎。不過,史蒂芬·霍金使用的裝置是 Speech Plus 的 CallText 5010,而非 DECtalk。兩者與 MITalk 相關的技術淵源有所重疊,不代表它們是同一項產品。
產生語音的方式也有差異。下表列出代表性方法,並不是把所有合成技術分成兩類。
表格若超出畫面寬度,可左右捲動。
| 方式 | 基本概念 |
|---|---|
| 共振峰合成 | 將聲道共振等特性建模,再產生語音;DECtalk 屬於這類技術。 |
| 串接式合成 | 選取並串接錄好的語音片段,同時處理銜接與語調。 |
歷史資料來源為 Computer History Museum;方式比較參照該館與 Google DeepMind。完整文獻連結列於文末。
作業系統、語音引擎與 API 是不同層次
桌面作業系統長期透過 API,讓應用程式使用語音功能。Microsoft 的 Speech API(SAPI)就是一例。把 SAPI 稱為「串接式合成引擎」並不精確:API 是呼叫介面,背後將文字轉成聲音的引擎則是另一層。
Web Speech API 同樣是瀏覽器呼叫語音合成功能的介面。作業系統已安裝的語音,不一定全部提供給瀏覽器使用。可用性、語音種類與處理位置會隨瀏覽器、作業系統、設定及服務而改變,應透過該環境的 getVoices() 確認實際清單。
Web Speech API 的範圍與支援狀態
Web Speech API 同時涵蓋將聲音轉成文字的語音辨識,以及將文字轉成聲音的語音合成。本文討論後者,不能直接把辨識功能的支援狀況或麥克風權限條件套用到合成。
2026 年 11 月 12 日查核的規格文件是 Draft Community Group Report,並非 W3C Recommendation。因此,不宜將它描述成「2012 年已完成的最終規格」。
Can I use 的語音合成支援表列出 Chrome 33、Safari 7、Firefox 49 與 Edge 14 等起始版本。這些是 API 支援歷程的參考,不代表特定語音、語言、音質或所有細節在各瀏覽器都相同。實際使用前仍需檢查 API、語音清單,並在目標裝置上測試。
API 如何運作:建立發話物件並選擇語音
請在 HTML 的 <button id="speak" type="button">朗讀</button> 元素之後放入以下 script。範例由點擊觸發短句朗讀;若沒有標示為台灣華語的本機語音,就不播放。這裡假設只有此範例管理頁面的語音佇列。
一般而言,speak() 會將發話加入佇列;本例先用 cancel() 停止並移除先前發話,因此在語音可用時再次點擊,會開始新的發話。resume() 不會復原已取消的發話。若初始清單是空的,請等語音載入後再次點擊;後面的清單監聽範例不會自動重試播放。
if ("speechSynthesis" in window && "SpeechSynthesisUtterance" in window) {
  const synth = window.speechSynthesis;
  document.getElementById("speak").addEventListener("click", () => {
    const voice = synth.getVoices().find(v =>
      v.localService && /^zh-(?:Hant-)?TW$/i.test(v.lang));
    if (!voice) {
      console.log("目前尚無可用的台灣華語本機語音");
      return;
    }
    const utterance = new SpeechSynthesisUtterance("你好,歡迎使用語音合成。");
    utterance.voice = voice;
    utterance.lang = voice.lang;
    utterance.rate = 1;
    utterance.pitch = 1;
    utterance.volume = 1;
    utterance.onend = () => console.log("收到發話結束通知");
    utterance.onerror = event => console.error("朗讀發生錯誤", event.error);
    synth.cancel();
    synth.resume();
    synth.speak(utterance);
  });
} else {
  console.log("此環境不支援語音合成 API");
}
範例接受語言標籤為 zh-TW 或 zh-Hant-TW 的本機語音,不會自動改用其他地區或遠端語音;這是範例的選擇條件,不代表所有系統都以相同標籤提供語音。實際口音與品質仍須試聽。
speak() 需要發話物件作為參數,呼叫成功不等於播放成功,因此仍要處理錯誤。API 的 rate 範圍是 0.1–10、pitch 是 0–2、volume 是 0–1,但各引擎的支援範圍與效果可能不同。此短例不包含長文分段、逾時處理或畫面狀態顯示。
語音清單可能稍後才更新
第一次取得清單時可能是空陣列,因此要同時處理初次讀取與 voiceschanged 事件。下方是獨立範例,只記錄清單,不會自動播放。畫面或元件卸載時應呼叫回傳的函式,移除監聽器。若清單一直是空的,也要確認作業系統的語音設定與瀏覽器提供條件。
function watchLocalVoices(onChange) {
  if (!("speechSynthesis" in window)) return () => {};
  const synth = window.speechSynthesis;
  const update = () => onChange(synth.getVoices().filter(v =>
    v.localService && /^zh-(?:Hant-)?TW$/i.test(v.lang)));
  synth.addEventListener("voiceschanged", update);
  update();
  return () => synth.removeEventListener("voiceschanged", update);
}
const stopWatching = watchLocalVoices(voices => console.log(voices));
// 畫面或元件卸載時,呼叫 stopWatching()。
發話事件包括 start、end、error、pause 與 resume。boundary 可通知單字或句子的邊界,但不同引擎不一定提供相同粒度的通知。結束通知也不代表使用者確實聽到聲音,或發音完全正確。
語音差異與隱私
語音的種類與品質取決於瀏覽器、作業系統、裝置設定及語音服務。不能只憑瀏覽器名稱就保證某個聲音或音質,應檢查 getVoices() 的結果。語音名稱不一定唯一,清單更新後,同一陣列位置也不一定仍是原本的語音。
localService 是瀏覽器回報的處理分類:true 表示本機服務,false 表示遠端服務。遠端服務可能把文字傳送給語音提供者。這個欄位並不保證裝置或擴充功能完全不會進行網路通訊。
NanToo 的文字朗讀工具(日文介面)預設只顯示本機語音。使用遠端語音時,需要取消篩選並明確選取;若選取的語音消失,工具不會自動切換成其他語音。工具沒有把輸入文字傳送或儲存到 NanToo 伺服器的處理,但涉及敏感資訊時,仍需確認裝置與語音提供者的條件。
神經網路 TTS:WaveNet 與 Tacotron 2
2016 年發表的 WaveNet 是自迴歸神經網路,逐一產生原始音訊取樣值。下一個取樣值以先前產生的值為條件,因此早期方法有運算成本高的問題。聆聽測試所呈現的改善,僅適用於該實驗的系統與條件,不能推論它優於所有語音合成系統。
Google 在 2017 年 12 月介紹的 Tacotron 2,先從文字字元預測梅爾頻譜圖,再透過 WaveNet 類型的聲碼器轉成音訊波形。梅爾頻譜圖使用考量人類聽覺的尺度,表示頻率分布隨時間的變化。這個以字元為輸入的例子,不應被描述成「一定從音素序列產生語音」。
Microsoft 於 2018 年 9 月公布神經網路 TTS 服務預覽版。不過,研究或雲端產品的發表,不代表該語音會出現在某個瀏覽器的 getVoices() 清單。神經網路 TTS 也有多種架構,不能把所有方法都限定為固定的三階段流程。
長文朗讀與播放狀態管理
Chromium 過去曾有長文朗讀中途停止的問題回報,但不能因此認定目前所有環境都有共同的 15 秒限制。定期呼叫 pause() 與 resume() 也無法保證穩定播放。
cancel() 會清空發話佇列,但不會解除暫停狀態;開始新的播放時,可用 resume() 解除。每次播放及每個發話物件都應有自己的識別,避免把已停止發話的延遲事件誤認為新播放的事件。錯誤與完成要分開處理,也不應無限等待沒有回應的引擎。
NanToo 工具接受最多 5,000 個 UTF-16 碼元,並在不切斷字素叢集的前提下,分成每段最多 200 個碼元。輸入過長時,只保留前 5,001 個碼元以偵測超限,不會播放。每段前後的空白會移除;若單一字素叢集超過 200 個碼元,則拒絕該輸入。每段上限為 90 秒,整次播放上限為 20 分鐘,包含暫停時間。背景分頁、螢幕鎖定或裝置睡眠可能使偵測與停止延後。變更文字、語音、篩選或設定時會停止播放。
分段不能保證消除引擎故障或發音錯誤,區段銜接處也可能出現不自然的停頓。完成狀態來自引擎通知,並不是實際量測音量或檢查發音的結果。
SSML:指定朗讀方式的標記語言
SSML(Speech Synthesis Markup Language)是以 XML 為基礎、用來描述朗讀方式的語言。SSML 1.1 於 2010 年 9 月 7 日成為 W3C Recommendation。下例包含 XML 命名空間,但不保證各瀏覽器產生相同的朗讀效果。
<speak xmlns="http://www.w3.org/2001/10/synthesis"
       version="1.1" xml:lang="zh-TW">
  你好。
  <break time="500ms"/>
  <prosody rate="slow" pitch="+10%">放慢速度,稍微提高音高。</prosody>
</speak>
break 指定停頓,prosody 調整速度、音高等屬性。音素表示法及 say-as 值的解讀,不一定在所有引擎間通用。
Web Speech API 規格允許發話文字採用純文字或格式良好的 SSML,但實際解讀與支援範圍取決於實作,因此不能說只有雲端 API 能處理 SSML。NanToo 工具不接受 SSML/XML 或以角括號包住的表達式,只提供純文字搭配 rate、pitch、volume 設定的播放。
使用前需要了解的限制
- 語音與音質:取決於瀏覽器、作業系統、設定及語音提供者。
- 音訊資料:SpeechSynthesis 沒有將合成結果回傳為 Blob 或音訊串流的標準方法,單純加入 WebCodecs 並不會讓輸出變得可讀取。
- SSML 與事件:需要依各實作確認。
- 長文:分段與逾時是處理措施,不代表所有環境都能完整播放。
- 自訂語音:沒有讓網頁把任意模型註冊到 SpeechSynthesis 語音清單的 API。
透過 WebAssembly 或 WebGPU 執行獨立的 TTS 模型,與使用瀏覽器提供的 SpeechSynthesis 服務是不同設計。若目的只是朗讀文字,先確認可用語音、處理位置與播放狀態管理;若需要產生音訊檔案或使用特定模型,則應評估支援該需求的其他合成方式。
參考資料與來源
- webaudio.github.io: Web Speech API ↗
- MDN Web Docs: ウェブ音声 API - Web API ↗
- caniuse.com: Speech Synthesis API | Can I use... Support tables for HTML5, CSS3, etc ↗
- computerhistory.org: Bringing A New Voice to Genius—MITalk, the CallText 5010, and Stephen Hawking’s Wheelchair - CHM ↗
- Google Research: Tacotron 2: Generating Human-like Speech from Text ↗
- Microsoft Azure Blog: Microsoft’s new neural text-to-speech service helps machines speak like people ↗
- Chromium: Speech Synthesis stops abruptly after about 15 seconds ↗
- Google DeepMind: WaveNet: A generative model for raw audio ↗
- Microsoft Learn: Text-to-Speech Tutorial (SAPI 5.3) ↗
- MDN Web Docs: SpeechSynthesis: getVoices() method - Web APIs ↗
- MDN Web Docs: SpeechSynthesis: cancel() method - Web APIs ↗
- W3C: Speech Synthesis Markup Language (SSML) Version 1.1 ↗
- WHATWG: HTML Standard ↗
- MDN Web Docs: SpeechSynthesisUtterance - Web APIs ↗
- MDN Web Docs: SpeechSynthesisVoice: localService property - Web APIs ↗
- MDN Web Docs: SpeechSynthesisUtterance: boundary event - Web APIs ↗
編輯說明
本文使用 AI 協助編輯,並於發布前由編輯確認。內容仍可能包含事實、解讀或時效上的錯誤;進行重要判斷前,請查閱所列的一手資料或官方文件。